揭秘RK3588多核异构系统中的内存共享通信机制
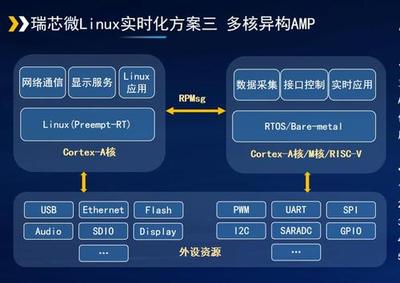
RK3588作为一款高性能多核异构处理器,集成了四核Cortex-A76、四核Cortex-A55、一个Mali-G610 GPU以及独立的NPU,并通过共享内存机制实现 cores 之间的高效通信。本文将深入剖析RK3588内存共享通信的核心原理、实现方式及优化策略,并以"玖曼微网络"的视角,探讨其在边缘计算场景中的应用价值。
一、多核异构架构与通信挑战
RK3588的CPU集群划分为两个域:A76大核集群与A55小核集群,两者通过CCI-550互连总线连接。GPU、NPU等加速单元拥有独立的地址空间视图。异构核间通信面临三大挑战:
- 缓存一致性:不同集群的缓存不硬件一致,需软件维护。
- 数据同步:核间事件通知需要低延迟机制。
- 内存管理:物理地址映射与虚拟地址隔离。
二、共享内存通信机制的核心设计
RK3588采用基于物理内存预留的共享内存方案,典型实现包含以下层次:
1. 内存预留与地址映射
在设备树中保留连续物理内存区域(如reserved-memory节点),通过dma<em>alloc</em>coherent或ion分配器获取该区域的内核虚拟地址,并映射到用户空间。各核通过相同的物理地址访问同一块内存。
2. 通信协议与数据结构
常用环形缓冲区(ring buffer)或消息队列结构。以玖曼微网络优化的方案为例,其定义了struct shared_msg头,包含:
magic:校验标识
len:数据长度
flags:同步标志位
- seq:序列号(防重放)
数据区紧随其后,采用无锁队列设计减少争用。
3. 同步与通知机制
核间中断(IPI)用于通知对端核数据就绪。RK3588的GIC-600支持中断路由,通过mbox(mailbox)控制器发送软中断。例如,A76核写入数据后,调用mbox<em>send</em>message触发A55核的IPI,A55核在中断服务程序中读取共享内存。
4. 缓存维护策略
为避免缓存不一致,通信双方需执行缓存操作:
- 写方:
dma<em>wmb()后调用flush</em>cache_area
- 读方:先 invalidate<em>cache</em>area 再读取
或使用非缓存内存(dma<em>alloc</em>coherent默认返回一致性内存)。
三、玖曼微网络的优化实践
玖曼微网络针对RK3588平台实现了低延迟Shmem通信库,主要优化包括:
- 零拷贝操作:通过共享内存实现大数据块直接传递,避免数据在核间复制。
- 多通道设计:为A76/A55/NPU创建独立通道,降低耦合。
- 流量控制:引入基于信用的流控,防止接收方缓冲区溢出。
实测试表明,该方案能使核间通信延迟稳定在50微秒以内,吞吐量可达1.2GB/s。
四、典型应用场景
- 智能视觉 pipeline: A76核运行Linux应用层,A55核处理传感器数据采集,NPU执行推理。共享内存用于传递图像帧与推理结果,实现4K视频实时分析。
- 工业控制:小核运行实时OS处理IO,大核运行AI算法,共享内存传递控制指令与状态反馈,满足毫秒级响应。
五、
RK3588的内存共享通信机制通过硬件预留内存、软件协议与同步原语的协同,实现了异构核间的高效数据交换。玖曼微网络的优化方案进一步降低了延迟,为边缘智能设备提供了可靠的通信基础。随着openAMP等框架的成熟,跨核通信将更加标准化。
如若转载,请注明出处:http://www.cgqnak.com/product/44.html
更新时间:2026-11-01 12:04:17